0%

实战操刀

下载数据集

https://data.vision.ee.ethz.ch/cvl/rrothe/imdb-wiki/static/imdb_crop.tar
https://data.vision.ee.ethz.ch/cvl/rrothe/imdb-wiki/static/wiki_crop.tar
数据说明:https://data.vision.ee.ethz.ch/cvl/rrothe/imdb-wiki/

解析元数据

元数据wiki.mat、imdab.mat是已matlab形式的mat文件存的,可以用scipy.io.loadmat读取。

属性 含义
gender nan/0/1 0 for female and 1 for male, NaN if unknown
face_score nan/float NaN 没有人脸,得分越高越确定人脸
second_face_score nan或float 第二张人脸的的人,越高越确定,_NaN_表示没有第二张脸
dob 不知道 date of birth (Matlab serial date number)用来算age,有些age算出来超出常理。要丢弃

论文笔记

人脸图像的年龄估计技术研究

王先梅,综述,主要讲述深度学习前的人脸年龄估计的技术。包括特征提取和估计算法等,很全面。

基于卷积神经网络的人脸年龄估计算法

周旺,南京大学。主要使用显著图方式增强数据,并对数据倾斜部分的进行迁移学习训练。能学会数据增加方式和迁移学习。提供了开源做法的指引

人脸检测及人脸年龄与性别识别方法

张军挺,中国科学技术大学,faster r-cnn用cnn提取特征;多尺度LBP+AdaBoost;深度和传统方式都做了,rcnn也用了迁移学习的方法。提取后使用随机森林做预测

Deep expectation of real and apparent age from a single image without facial landmarks

LAP2015冠军,imdb-wiki数据提供者
旋转图片后,选择最高分的脸。
脸扩展40%的像素,以免脸的边缘到达图片边缘(padding时候有问题,也就是脸过大的问题),也使得所有图片保持一致。如果找不到脸,用整张图。
vgg16迁移
分类预测–>加权平均

Apparent Age Estimation from Face Images Combining General and Children-Specialized Deep Learning Models

LAP2016,人脸年龄v2比赛冠军
年龄编码的方式

##Apparent Age Estimation Using Ensemble of Deep Learning Models
LAP2016, 人脸年龄v2第5名

code

hog.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
from skimage import feature as ft
from skimage import io
import argparse
import utils
import math
import multiprocessing
import os
import tqdm


def extract_hog(img_full_path):
ori = 8
ppc = (16, 16)
cpb = (1, 1)
image = io.imread(img_full_path)
features = ft.hog(image, # input image
orientations=ori, # number of bins
pixels_per_cell=ppc, # pixel per cell
cells_per_block=cpb, # cells per blcok
block_norm='L2-Hys', # block norm : str {‘L1’, ‘L1-sqrt’, ‘L2’, ‘L2-Hys’}, optional
transform_sqrt=True, # power law compression (also known as gamma correction)
feature_vector=True, # flatten the final vectors
visualise=False) # return HOG map
return features


def task(data_dir, stage, paths, ages, position):
file_name = os.path.join(data_dir, "%s_%d.txt" % (stage, position))
with open(file_name, 'w') as f:
for i, img_path in enumerate(paths):
img_path = img_path[1:] if img_path[0] == "/" else img_path
features = extract_hog(os.path.join(data_dir, img_path))
line = ",".join([str(a) for a in features]) + "," + str(ages[i]) + "\n"
f.write(line)
return file_name


def merge_pool_results(data_dir, results):
merged_file = os.path.join(data_dir, "hog.txt")
with open(merged_file, 'w') as wf:
for file in results:
with open(file, 'r') as rf:
wf.writelines(rf.readlines())
# os.remove(file)


def simple_process(data_dir, meta_file):
"""not fast enough"""
paths = list()
ages = list()
with open(os.path.join(data_dir, meta_file), 'r') as f:
for line in f.readlines():
ss = line.split(" ")
paths.append(ss[0])
ages.append(ss[1])
with open(os.path.join(data_dir, "hog_all.txt"), 'w') as f:
for i in tqdm.trange(len(paths)):
feature = extract_hog(os.path.join(data_dir, paths[i]))
line = ",".join([str(a) for a in feature]) + "," + str(ages[i]) + "\n"
f.write(line)


if __name__ == '__main__':
parser = argparse.ArgumentParser()
parser.add_argument('--data_dir', required=False, help='data dir')
parser.add_argument('--process', required=False, help='how many process')

args = parser.parse_args()
process = int(args.process) if args.process else 32
data_dir = args.data_dir if args.data_dir else "/home/tony/data"

stage = "hog"
meta_file = "aligned_meta.txt"

results = list()

train_path, train_age = utils.read_meta_data(data_dir, meta_file)
# train_path = train_path[0:100]
# train_age = train_age[0:100]
n = int(math.ceil(len(train_path) / float(process)))
print(len(train_path))

pool = multiprocessing.Pool(processes=process)
for i in range(0, len(train_path), n):
t = pool.apply_async(task, args=(data_dir, stage, train_path[i: i + n], train_age[i:i + n], i,))
results.append(t)
pool.close()
pool.join()

merge_pool_results(data_dir, [t.get() for t in results])
[os.remove(os.path.join(data_dir, t.get())) for t in results]


align.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
# -*- coding: utf-8 -*-
import cv2
import dlib
import os
import sys
from imutils.face_utils import FaceAligner
from tqdm import tqdm
import math
from multiprocessing import Process as pro, Pool
import argparse
import utils

cur_dir = os.path.dirname(__file__)
# cur_dir = os.path.dirname(os.path.abspath(__file__))
data_dir = os.path.join(cur_dir, "data")
# data_dir = r"d:/data" # special for windows
classifier_xml = os.path.join(data_dir, "haarcascade_frontalface_alt2.xml")
predictor_path = os.path.join(data_dir, "shape_predictor_68_face_landmarks.dat")

detector = dlib.get_frontal_face_detector()
predictor = dlib.shape_predictor(predictor_path)
fa = FaceAligner(predictor, desiredFaceWidth=160)


def opencv_recognize(img_path):
face_patterns = cv2.CascadeClassifier(classifier_xml)
sample_image = cv2.imread(img_path)
# cv2.imshow("image", sample_image)
faces = face_patterns.detectMultiScale(sample_image, scaleFactor=1.1, minNeighbors=5, minSize=(100, 100))

for (x, y, w, h) in faces:
cv2.rectangle(sample_image, (x, y), (x + w, y + h), (0, 255, 0), 2)

# cv2.imwrite('/Users/abel/201612_detected.png', sample_image)
cv2.imshow("image", sample_image)
cv2.waitKey(0)
cv2.destroyAllWindows()


def dlib_recognize_and_align(img_path):
'''加载人脸检测器、加载官方提供的模型构建特征提取器'''
win = dlib.image_window()
detector = dlib.get_frontal_face_detector()
predictor = dlib.shape_predictor(predictor_path)
brg_img = cv2.imread(img_path)
rgb_img = cv2.cvtColor(brg_img, cv2.COLOR_BGRA2RGB)
dets = detector(rgb_img, 1)
print("Number of faces detected: {}".format(len(dets)))
for i, d in enumerate(dets):
print("Detection {}: Left: {} Top: {} Right: {} Bottom: {}".format(
i, d.left(), d.top(), d.right(), d.bottom()))

win.clear_overlay()
win.set_image(rgb_img)
win.add_overlay(dets)
dlib.hit_enter_to_continue()
pass


def align_and_save(data_dir, img_path):
full_path = os.path.join(data_dir, img_path)
bgr_img = cv2.imread(full_path, 0)
gray = bgr_img
# gray = cv2.cvtColor(bgr_img, cv2.COLOR_BGR2GRAY)
rects = detector(gray, 1)
if len(rects) != 1:
return False
img = fa.align(gray, gray, rects[0])
new_file_path = os.path.join(data_dir, "aligned", img_path)
aligned_dir = os.path.dirname(new_file_path)
if not os.path.exists(aligned_dir):
os.makedirs(aligned_dir)
cv2.imwrite(new_file_path, img)
return True


def crop_train_face(train_path, train_age):
"""single process"""
pre_len = len(train_path)
new_path = list()
new_age = list()
for i in tqdm(range(pre_len)):
img_path = data_dir + train_path[i]
new_file_path = align_and_save(img_path)
new_path.append(new_file_path)
new_age.append(train_age[i])
return new_path, new_age


def task(data_dir, stage, img_paths, ages, position):
file_name = os.path.join(data_dir, "%s_%d.txt" % (stage, position))
with open(file_name, 'w') as f:
for i, img_path in enumerate(img_paths):
img_path = img_path[1:] if img_path[0] == "/" else img_path
if align_and_save(data_dir, img_path):
f.write("aligned/%s %d\n" % (img_path, ages[i]))
return file_name


def merge_pool_results(data_dir, results):
merged_file = os.path.join(data_dir, "aligned_meta.txt")
with open(merged_file, 'w') as wf:
for file in results:
with open(file, 'r') as rf:
wf.writelines(rf.readlines())
os.remove(file)

def chunks(arr, m):
n = int(math.ceil(len(arr) / float(m)))
return [arr[i:i + n] for i in range(0, len(arr), n)]


if __name__ == '__main__':
parser = argparse.ArgumentParser()
parser.add_argument('--data_dir', required=False, help='data dir')
parser.add_argument('--process', required=False, help='how many process')

args = parser.parse_args()
process = int(args.process) if args.process else 32
data_dir = args.data_dir if args.data_dir else "/home/tony/data"

stage = "train"
meta_file = "wiki.txt"
results = list()
train_path, train_age = utils.read_meta_data(data_dir, meta_file)
n = int(math.ceil(len(train_path) / float(process)))
print(len(train_path))

pool = Pool(processes=process)
for i in range(0, len(train_path), n):
t = pool.apply_async(task, args=(data_dir, stage, train_path[i: i + n], train_age[i:i + n], i,))
results.append(t)
pool.close()
pool.join()

merge_pool_results(data_dir, [t.get() for t in results])


unify_meta_data.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
# -*- coding: utf-8 -*-
import logging
from utils import get_meta
from tqdm import trange
import numpy as np
import os
import sys

MAX_AGE = 117
logger = logging.getLogger()
handler = logging.StreamHandler()
formatter = logging.Formatter(
'%(asctime)s %(name)s %(levelname)s %(message)s')
handler.setFormatter(formatter)
logger.addHandler(handler)
logger.setLevel(logging.DEBUG)


def filter_unusual(full_path, gender, face_score, second_face_score, age):
# label filter
gender_idx = np.where(~np.isnan(gender))[0]
age_idx = [i for i in range(len(age)) if 0 <= age[i] <= MAX_AGE]
# face filter
# face_score_idx = np.where(face_score <= 0)[0]
# second_face_score_idx = np.where(second_face_score>0)[0]

return np.intersect1d(gender_idx, age_idx)


def main_process(data_path, db, limit=None):
mat_path = os.path.join(data_path, db + "_crop", db + ".mat")
full_path, dob, gender, photo_taken, face_score, second_face_score, age = get_meta(mat_path, db)
ok_idx = filter_unusual(full_path, gender, face_score, second_face_score, age)
meta_file = os.path.join(data_path, db + ".txt")
with open(meta_file, 'w') as f:
for i in trange(len(ok_idx)):
if limit and i >= int(limit):
break
f.write("%s_crop/%s %d\n" % (db, full_path[i][0], age[i]))
return meta_file

if __name__ == '__main__':
data_path = str(sys.argv[1]) if len(sys.argv) > 1 else r"d:/data"
data_path = "/home/tony/data"
db = "wiki"
meta_file = main_process(data_path, db)
print("meta_file: " + meta_file)

utils.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
# utils.py
# -*- coding: utf-8 -*-
from scipy.io import loadmat
from datetime import datetime
import os
import numpy as np


def calc_age(taken, dob):
birth = datetime.fromordinal(max(int(dob) - 366, 1))
# assume the photo was taken in the middle of the year
if birth.month < 7:
return taken - birth.year
else:
return taken - birth.year - 1


def get_meta(mat_path, db):
meta = loadmat(mat_path)
full_path = meta[db][0, 0]["full_path"][0]
dob = meta[db][0, 0]["dob"][0] # Matlab serial date number
gender = meta[db][0, 0]["gender"][0]
photo_taken = meta[db][0, 0]["photo_taken"][0] # year
face_score = meta[db][0, 0]["face_score"][0]
second_face_score = meta[db][0, 0]["second_face_score"][0]
# age = np.array(map(calc_age, photo_taken, dob)) # python 2/3 staff
age = [calc_age(photo_taken[i], dob[i]) for i in range(len(dob))]
return full_path, dob, gender, photo_taken, face_score, second_face_score, age


def mk_dir(dir):
try:
os.mkdir(dir)
except OSError:
pass


def read_meta_data(data_dir, file_name):
path = list()
age = list()
with open(os.path.join(data_dir, file_name)) as f:
for line in f.readlines():
ss = line.split(" ")
path.append(ss[0])
age.append(int(ss[1]))
return path, age


if __name__ == '__main__':
mat_path = r"D:\wiki_crop\wiki.mat"
db = "wiki"
full_path, dob, gender, photo_taken, face_score, second_face_score, age = get_meta(mat_path, db)

svm.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import pandas as pd
import os
import numpy as np
import argparse
from sklearn import svm
from sklearn.model_selection import train_test_split
from sklearn.decomposition import PCA
import sklearn


data_dir = "/home/tony/data"
hog_file = "hog.txt"

train_data = pd.read_csv(os.path.join(data_dir, hog_file), header=None)
X_train, X_test, y_train, y_test = train_test_split(train_data.values[:, 0:-1], train_data.values[:, -1],
test_size=0.1, random_state=2018, shuffle=True)

# PCA
# pca = PCA(n_components=100, whiten=True)
# X_train = pca.fit_transform(X_train)
# X_test = pca.fit_transform(X_test)
# print(X_train.shape)
# print(X_test.shape)


# svc
svr = svm.LinearSVR()
svr.fit(X_train, y_train)
pre = svr.predict(X_test)

# metrics
mae = sklearn.metrics.mean_absolute_error(y_test, pre)
print("mae: %f" % mae)

rfr.py

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
import pandas as pd
import os
import numpy as np
import argparse
from sklearn import svm
from sklearn.model_selection import train_test_split
from sklearn.decomposition import PCA
import sklearn
from sklearn.ensemble import RandomForestRegressor


data_dir = "/home/tony/data"
hog_file = "hog.txt"

train_data = pd.read_csv(os.path.join(data_dir, hog_file), header=None)
X_train, X_test, y_train, y_test = train_test_split(train_data.values[:, 0:-1], train_data.values[:, -1],
test_size=0.1, random_state=2018, shuffle=True)

# PCA
# pca = PCA(n_components=100, whiten=True)
# X_train = pca.fit_transform(X_train)
# X_test = pca.fit_transform(X_test)
# print(X_train.shape)
# print(X_test.shape)


# svc
regr = RandomForestRegressor(n_estimators=320, n_jobs=32, random_state=2018, verbose=1)
regr.fit(X_train, y_train)
pre = regr.predict(X_test)

# metrics
mae = sklearn.metrics.mean_absolute_error(y_test, pre)
print("mae: %f" % mae)

试验数据

各类特征pca512后,直接串连

LogisticRegression

LogisticRegression on hog(512) resulting mae: 12.534653
LogisticRegression on lbp(512) resulting mae: 12.316832
LogisticRegression on vgg(512) resulting mae: 5.792079
LogisticRegression on hog_lbp(1024) resulting mae: 12.564356
LogisticRegression on hog_vgg(1024) resulting mae: 4.762376
LogisticRegression on lbp_vgg(1024) resulting mae: 5.118812
LogisticRegression on hog_lbp_vgg(1536) resulting mae: 4.841584

LinearSVR

LinearSVR on hog(512) resulting mae: 13.975740
LinearSVR on lbp(512) resulting mae: 14.171815
LinearSVR on vgg(512) resulting mae: 6.477576
LinearSVR on hog_lbp(1024) resulting mae: 22.368721
LinearSVR on hog_vgg(1024) resulting mae: 9.580384
LinearSVR on lbp_vgg(1024) resulting mae: 11.537682
LinearSVR on hog_lbp_vgg(1536) resulting mae: 6.361257

SVR(rbf)

SVR on hog(512) resulting mae: 11.496392
SVR on lbp(512) resulting mae: 11.600109
SVR on vgg(512) resulting mae: 11.721817
SVR on hog_lbp(1024) resulting mae: 11.682743
SVR on hog_vgg(1024) resulting mae: 11.624635
SVR on lbp_vgg(1024) resulting mae: 11.608328
SVR on hog_lbp_vgg(1536) resulting mae: 11.349862

rf

RandomForestRegressor on hog(512) resulting mae: 11.234653
RandomForestRegressor on lbp(512) resulting mae: 12.245545
RandomForestRegressor on vgg(512) resulting mae: 5.855446
RandomForestRegressor on hog_lbp(1024) resulting mae: 10.981188
RandomForestRegressor on hog_vgg(1024) resulting mae: 5.754455
RandomForestRegressor on lbp_vgg(1024) resulting mae: 5.740594
RandomForestRegressor on hog_lbp_vgg(1536) resulting mae: 6.240594

ada

AdaBoostRegressor on hog(512) resulting mae: 11.469027
AdaBoostRegressor on lbp(512) resulting mae: 11.945927
AdaBoostRegressor on vgg(512) resulting mae: 6.560440
AdaBoostRegressor on hog_lbp(1024) resulting mae: 10.853807
AdaBoostRegressor on hog_vgg(1024) resulting mae: 6.464129
AdaBoostRegressor on lbp_vgg(1024) resulting mae: 6.640677
AdaBoostRegressor on hog_lbp_vgg(1536) resulting mae: 6.807597

直接串联融合

先全部pca skb-f_regression skb-mutual_info_regression

LinearSVR

LinearSVR on hog_lbp(300) resulting mae: 6.277855
LinearSVR on hog_vgg(300) resulting mae: 5.596323
LinearSVR on lbp_vgg(300) resulting mae: 6.167967
LinearSVR on hog_lbp_vgg(300) resulting mae: 5.759966

LinearSVR on hog_lbp(150) resulting mae: 5.891156
LinearSVR on hog_vgg(150) resulting mae: 5.809739
LinearSVR on lbp_vgg(150) resulting mae: 5.940609
LinearSVR on hog_lbp_vgg(150) resulting mae: 5.626772

LinearSVR on hog_lbp(60) resulting mae: 5.666367
LinearSVR on hog_vgg(60) resulting mae: 5.797798
LinearSVR on lbp_vgg(60) resulting mae: 6.250504
LinearSVR on hog_lbp_vgg(60) resulting mae: 5.709871

hog-pca512,lbp-pac512,vgg512后融合

PCA30+LDA30+f_regression30+mutual_info_regression30
LinearSVR on hog_lbp(120) resulting mae: 2.708872
LinearSVR on hog_vgg(120) resulting mae: 2.525526
LinearSVR on lbp_vgg(120) resulting mae: 2.654724
LinearSVR on hog_lbp_vgg(120) resulting mae: 4.254801

hog-1700+, lbp-16000+, vgg512融合

PCA30+LDA30+f_regression30+mutual_info_regression30
LinearSVR on hog_lbp(120) resulting mae: 3.564676
LinearSVR on hog_vgg(120) resulting mae: 3.800873
LinearSVR on lbp_vgg(120) resulting mae: 5.523058
LinearSVR on hog_lbp_vgg(120) resulting mae: 5.760532>
第一次用RobotFramework-SeleniumLibrary写网页的GUI测试,封装关键字,按功能模块划分关键字。后来一次系统层面的UI重构,所有用例要重新写,成本很大,遂找到2013年提出,2015成熟的Page Object设计模式。基于页面或重用组件封装,仅将人类能交互的操作封装为方法。抽象后,可读性、可维护性大增。

阅读全文 »

Docker运行Jenkins有诸多不便,尽量不要使用。
较新版本Jenkins限制了js和css的运行,然而RobotFramework的日志log.html和报告report.html都严重依赖js和css。docker平台上最简单解决方法就是用JAVA_OPTS-Dhudson.model.DirectoryBrowserSupport.CSP=,放松Jenkins的安全策略。缺失字体库会造成显示成方块的问题

阅读全文 »

Hadoop组件运维命令

TODO

Agent在supervise的方式下启动,如果进程死掉会被系统立即重启,以提供服务。

简介

项目中初次使用原生的Hadoop集群,各组件不稳定,常需要各种重启命令。

Hadoop 2.7

应该按照下文的顺序启动集群,更详细的说明请参考# HA 模式下的 Hadoop+ZooKeeper+HBase 启动顺序

  1. ZooKeeper
    节点规划中,zookeeper跟journalnode放在一起,共5个节点
    1
    2
    zkServer.sh start  # QuorumPeerMain
    hadoop-daemon.sh start journalnode # JournalNode
  2. 启动NameNode
    1
    hadoop-daemon.sh start namenode
  3. 启动DataNode
    1
    2
    hadoop-daemon.sh start datanode  # 单个
    hadoop-daemons.sh start datanode # 整个集群
  4. 启动ResourceManager
    1
    yarn-daemon.sh start resourcemanager
  5. 启动NodeManager
    1
    2
    yarn-daemon.sh start nodemanager  # 单个
    yarn-daemons.sh start nodemanager # 整个集群
  6. 启动zkfc(DFSZKFailoverController) - HA两台master都要
    1
    hadoop-daemon.sh start zkfc
  7. 启动JobHistoryServer
    1
    mr-jobhistory-daemon.sh start historyserver
  8. 切换Active的NameNode
    1
    hdfs haadmin -failover nn2 nn1
  9. 查看hdfs状态
    1
    hdfs haadmin -getServiceState nn1
  10. 切换Active的ResourceManager

由于yarn rmadmin不支持-failover命令,只能kill掉active的ResourceManager进程,待切换后再查看

1
2
yarn rmadmin -getServiceState rm1 #查看状态 
yarn rmadmin -getServiceState rm2 #查看状态

nn1是namenode1,nn2是namenode2. 对应的配置文件是hdfs-site.xml

  1. 平衡

参考文章:
原因
参数
算法
任意节点执行: dfsadmin -setBalancerBandwidth 10485760 (=10MB/s)
该命令会在两个NameNode节点生效. 后续执行 hdfs balancer 会快很多.
默认是每个DataNode节点是1MB/s

生产环境点对点大约是60MB/s, 这样配置大约会占用六分之一的带宽.
不要再设置更大了, 因为多对机器传输累积到网关的速度就很大了.

hdfs balancer命令原本设计是常驻后台进程, 所以默认参数平衡时很慢的. 适用于长期运行, 不影响业务操作. 无限期后台hdfs balancer -idleiterations -1

1
2
dfsadmin -setBalancerBandwidth 10485760
hdfs balancer

Hbase

  1. 启动HMaster
    1
    hbase-daemon.sh start master
  2. 启动HRegionServer
    1
    2
    hbase-daemon.sh start regionserver  # 单个
    hbase-daemons.sh start regionserver # 整个集群

Hive

  1. 启动Metastore
    1
    2
    3
    # hive --service metastore  # 关键部分  
    nohup hive --service metastore > /home/hadoop/soft/hive/logs/metastore.log 2>&1 &

  2. 启动HiveServer2
    1
    2
    3
    # hive --service hiveserver2  # 关键部分  
    nohup hive --service hiveserver2 > /home/hadoop/soft/hive/logs/hiveserver2.log 2>&1 &

presto

coordinator和worker都是一样的启动命令

1
2
/home/hadoop/soft/presto/bin/launcher start

Azkaban

Azkaban工作流项目使用的是2.5.0版本,有Web和Executor两个组件

1
2
3
4
5
6
cd /home/hadoop/soft/azkaban-web-2.5.0/
nohup bin/azkaban-web-start.sh > /home/hadoop/soft/azkaban-web-2.5.0/webServer.log 2>&1 &

cd /home/hadoop/soft/azkaban-executor-2.5.0/
nohup bin/azkaban-executor-start.sh > /home/hadoop/soft/azkaban-executor-2.5.0/executorServer.log 2>&1 &

Kylin

1
2
3
cd /home/hadoop/soft/kylin/bin
sh kylin.sh start

Hue

1
2
cd  /home/hadoop/soft/hue
nohup build/env/bin/supervisor &

杀掉yarn上的任务

1
bin/yarn application -kill <applicationId>

统计hive数据仓库表占用空间

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
#!/usr/bin/env python  
# -*- coding: utf-8 -*-
import re
import os

cmd = "hdfs dfs -du -s /user/hive/warehouse/dwdb.db/* > /tmp/hive_dwdb_space.txt"
os.system(cmd)

path = r"/tmp/hive_dwdb_space.txt"

sum = 0
with open(path, 'r') as f:
for line in f.readlines():
ss = re.split("\s*", line)
s0 = int(ss[0])
s1 = ss[1]
if "prj_" in s1:
sum += s0
print(s1)
print("sum: %0.2f GB" % (sum * 1.0 / 1024 / 1024 / 1024))

hadoop mapreduce Job Name指定任务名

sqoop参数

sqoop export/import -Dmapreduce.job.name=”<你指定的任务名>”

参考

  1. Hadoop、Hbase原生脚本说明
  2. Hadoop+ZooKeeper+HBase 启动顺序
  3. HBASE启动脚本/Shell解析

最终项目夭折了,原因在于选型会议选择了另外一个工具基础上二次开发,另外一个原因是其实本身没有那么多自动化用例的日志可供分析。我们不是平台部门,是个小业务部门

阅读全文 »

背景

测试岗位却不甘止步于业务测试,遂尝试智能化测试,当前的思路是通过日志大数据分析,协助自动化用例的诊断和建议。

他山之石

《从日志统计到大数据分析》

知乎专栏作家桑文锋[http://SensorsData.cn](https://link.zhihu.com/?
target=http%3A//SensorsData.cn) 神策数据创始人&CEO

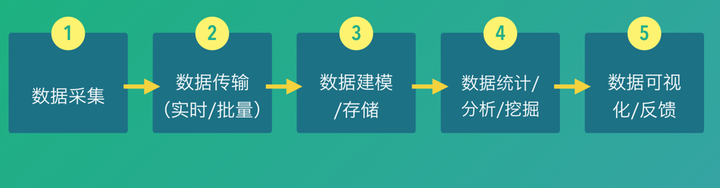
数据处理流程图
enter image description here

数据采集


  1. 多个来源、C/S(B/S)

  2. 多个维度,ip、url、时间、userid等等尽可能多
  3. 数据格式
  • Protocol Buffer:Google使用,较为重型
  • JSON:学习成本低
  • Thrift——由Facebook开源的一套开发框架和数据格式,相比PB,在解析效率上低点,但周边组件比较完善。
  • Avro——由Hadoop创始人Doug Cutting主导开发的,使用接口上和Thrift类似,有客户公司在使用。
    在简单看看文档后,估计会使用json。
  1. 数据类型
    被测应用自身日志、环境日志(cpu、容器内env)、测试脚本日志;
    应用代码、测试脚本(代码本身)
    数据库数据?

数据传输

【这段完全照抄】
1,FTP:数据量小且时效性要求不高,用FTP是最省事的。
2,Sqoop:用于传统数据库和Hadoop之间的数据传输。
3,Scribe:Facebook开源的一套日志传输系统,github上已经不维护了。
4,Flume:Cloudera开源的一套日志传输系统,和Scribe类似。我们在百度做的Minos,可以说是和Flume、Scribe类似,那为啥要重复造轮子?主要百度的数据源和服务器太多了,需要做许多功能来满足运维管理的问题。
5,Kafka:Linkedin开源的一套消息传输系统,和百度Bigpipe类似。我们Bigpipe开发了一半的时候,Kafka的论文发表了。Bigpipe会做去重,Kafka目前还没有这样的机制,需要自己去实现。两者都通过副本的机制,保证数据不丢。
Flume/Logstash/Beat 是同一类软件,如果抽象功能的话可以认为是一个插件执行器,有一些常用的插件(例如日志采集,Binlog解析,执行脚本等),也可以根据需求将自己的代码作为插件发布。

知乎靠谱答案

Kafka 一般作为Pub-Sub管道,没有抓取功能。一开始设计的时候主要是Jay Krep觉得Linkedin里面数据源,消费者之间关系太复杂,如果是N个数据源,M个消费者,需要拉N*M个线,并且接口和协议不同,所以使用了一种消息中间件来解耦数据源和消费者。但Kafka本身也不算消息中间件,中间件一般会有Queue和Topic两种模型,Kafka主要是Topic类的模型。

对搭建日志系统而言,也没什么新花样,以下这些依样画葫芦就可以了:

  1. 日志采集(Logstash/Flume,SDK wrapper)
  2. 实时消费 (Storm, Flink, Spark Streaming)
  3. 离线存储 (HDFS or Object Storage or NoSQL) + 离线分析(Presto,Hive,Hadoop)
  4. 有一些场景可能需要搜索,可以加上ES或ELK

小结

  1. 大概率采用Flume/kafka/hdfs(spark-ml)
  2. 重点关注部署与运维成本

数据建模/存储

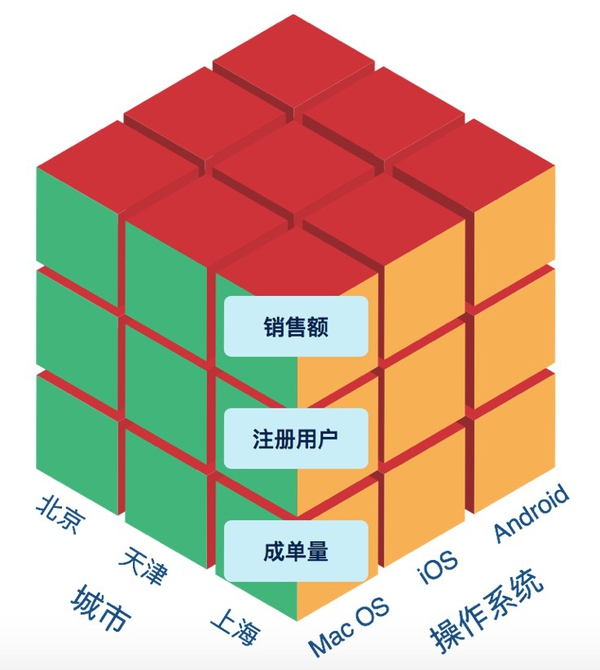
多维数据模型


在互联网产品中,最重要的有两类数据——业务数据和用户行为数据。对于用户行为数据,我们可以讲用户的每一次操作理解为一个事件(Event),事件有个类型如提交订单、提出问题等,事件发生时有响应的上下文,如使用的操作系统、浏览器版本等系统属性,也有事件特有的如运费、订单价格等属性,这些属性就是一系列的维度,还有一部分是事件发生的用户ID。即:

Event Type + Properties + UserID

这里就形成了一系列的维度,描述的最细粒度的事件现场。通过UserID,我们还会关联到UserID这一维度的详情(User Profile),包括姓名、出生日期、身高、是否有小孩等。

ETL存储

做好数据源,减少ETL。

思考

对于智能化测试来说,一个用例的执行应该就是一个事件,事件的属性可以是通过与否、报错信息、执行时间等,UserID可以是模块或者用例id吧。建模还是需要仔细考虑的。
不过数据源和ETL应该都只有测试自己搞了。

数据统计、分析、挖掘

数据驱动

能不能做好数据,开放自助查询的功能?

查询模式:

  • K-V(Key-Value)查询就是我们给出一个key,然后返回这个key相关的value内容。比如我们通过一个UserID,返回用户的一些画像信息,比如有没有房。再比如,通过UserID返回最近一段时间的详细访问行为序列。这里推荐使用HBase。
  • OLAP(Online Analytical Processing)查询就是前面讲的多维数据分析,这里不赘述。可以使用的工具有InfoBright、Vertica、Impala、Redshift等。
  • Ad Hoc查询就是有各种各样的不确定的需求,需要响应。这块可以用Hive,或者Spark SQL来满足,再不行就写程序自己实现吧。
  • ES,支持一些模糊的查询

统计

  1. 哪个模块失败数最多
  2. 什么时间段执行最多问题
  3. 什么类型的报错最多

分析

  1. 用例失败原因

挖掘

  1. 协助写用例 (推荐步骤、类似用例)
  2. 推断模块稳定性

可视化与反馈

可视化

  1. 对接看板,提供数据或时序交互,有点像数据底座的功能
  2. Echarts或D3提供web版基本的可视化功能
  3. Tableau

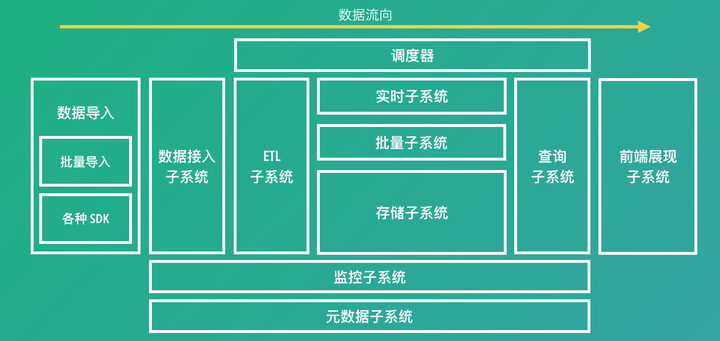
整体数据流与架构图


元数据和调度器分别是数据平台的心脏和大脑。

调度器

如果有很多请求的时候,需要优先级调度;(现在可能用不上)
如果请求有依赖的时候,使用DAG调度;(Azkaban可以完成)

元数据

开源实现可以参考Hcatalog,封装了hive meta。

元数据提供的服务 主要有三点:

  1. 数据的Schema:表、字段定义等。
  2. 数据的就绪状态:数据就绪时间、存放位置等动态信息。
  3. 元数据的访问API。
    扩展的服务还包括:
  • 权限控制(ACL):严格来说ACL不算元数据的一部分,但这两者关系太紧密,一般放在一起考虑。
  • 元数据的变更记录:谁做了什么操作好做审计,另外可以有元数据的版本信息,这样对历史数据的存取更方便一些。

hive on spark 安装配置

简介

网上的教程都说spark官网预编译的二进制文件含有hive部分,不能直接使用,需源码编译,包括hive的wiki也提及需要不含hive的jars。经过实践也可以通过剔除hive相关包,使用预编译的spark包完成hive-on-spark的部署。

环境

hadoop: 2.7.3
hive: 2.3.2
spark: 2.2.0
6个节点,4个nodemanager
hive 的wiki说只有对应的版本能保证兼容性,不是完全兼容也可以的。只是不知道有无隐患。

yarn配置

修改之后需要分发集群并重启

1
2
3
4
5
vim /home/hadoop/soft/hadoop/etc/hadoop/yarn-site.xml
<property>
<name>yarn.resourcemanager.scheduler.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.FairScheduler</value>
</property>

hdfs准备路径和jar包

新建spark-log目录

hdfs dfs -mkdir -p hdfs://ns1/spark/spark-log

上传jar包

hdfs dfs -mkdir -p hdfs://ns1/spark/jars
hdfs dfs -put $SPARK_HOME/jars/*.jar hdfs://ns1/spark/jars/

spark配置

配置spark-env.shslavesspark-defaults.conf三个文件
spark-env.sh

1
2
3
4
5
6
7
8
export SPARK_MASTER_WEBUI_PORT=8081
export SCALA_HOME=/home/hadoop/soft/scala
export JAVA_HOME=/home/hadoop/soft/jdk
export HADOOP_HOME=/home/hadoop/soft/hadoop
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
SPARK_MASTER_IP=master1
SPARK_LOCAL_DIRS=/home/hadoop/soft/spark
SPARK_DRIVER_MEMORY=4G

slaves 每行一个hostname或ip

1
2
3
4
5
hd2
hd4
hd5
hd6
hd7

spark-defaults.conf
以下配置按照NodeManager是12C12G计算

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
spark.master                        yarn
spark.home /home/hadoop/soft/spark
spark.eventLog.enabled true
spark.eventLog.dir hdfs://ns1/spark/spark-log
spark.serializer org.apache.spark.serializer.KryoSerializer
# hive on spark 建议5/6/7
spark.executor.cores 6
# 按6*12G/12vcores计算
spark.executor.memory 5222m
# 28个计算节点*每个节点2个executor
spark.executor.instances 56
# 所有core的两三倍:56*6*3=1008
spark.default.parallelism 1000
# 15% * spark.executor.memory
spark.yarn.executor.memoryOverhead 921m
spark.driver.memory 4g
spark.yarn.driver.memoryOverhead 400m
spark.yarn.jars hdfs://ns1/spark/jars/*.jar

拷贝到hive的配置目录,使调用hive时能识别使用spark-defaults.conf

1
ln -s ~/soft/spark/conf/spark-defaults.conf ~/soft/hive/conf/

验证spark

1
./bin/spark-submit --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode client ./examples/jars/spark-examples_2.11-2.2.0.jar 10

hive

添加必要的依赖库

1
2
3
ln -s /home/hadoop/soft/spark/jars/scala-library-2.11.8.jar /home/hadoop/soft/hive/lib/
ln -s /home/hadoop/soft/spark/jars/spark-network-common_2.11-2.2.0.jar /home/hadoop/soft/hive/lib/
ln -s /home/hadoop/soft/spark/jars/spark-core_2.11-2.2.0hiv.jar /home/hadoop/soft/hive/lib/

剔除spark中hive的库

1
2
3
mkdir hive-jars
mv /home/hadoop/soft/spark/jars/hive*.jar /home/hadoop/soft/spark/hive-jars

启用spark引擎

1为临时方案,2为默认配置

  1. 在命令行交互(进入hive之后)set hive.execution.engine=spark;
  2. 配置hive.site.xml文件,配置
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    <property>
    <name>hive.execution.engine</name>
    <value>spark</value>
    <description>
    Expects one of [mr, tez, spark].
    Chooses execution engine. Options are: mr (Map reduce, default), tez, spark. While MR
    remains the default engine for historical reasons, it is itself a historical engine
    and is deprecated in Hive 2 line. It may be removed without further warning.
    </description>
    </property>

验证hive on spark

  • 命令行输入 hive,进入hive CLI
  • set hive.execution.engine=spark; (将执行引擎设为Spark,默认是mr,退出hive CLI后,回到默认设置。若想让引擎默认为Spark,需要在hive-site.xml里设置)
  • create table test(ts BIGINT,line STRING); (创建表)
  • select count(*) from test;
  • 若整个过程没有报错,并出现正确结果,则Hive on Spark配置成功。

优化

因为在yarn上执行,拷贝spark的jars到hdfs上能避免每次拷贝。
如果仅是在hive中使用spark,可以在hive-site.xml中配置。由于在spark-defaults.conf已经配置过,这里可以不配置

1
2
3
4
<property>
<name>spark.yarn.jars</name>
<value>hdfs://ns1/spark/jars/*.jar</value>
</property>

其他

  1. hive的wiki
  2. Cloudera的翻译
  3. spark参数配置-美团
  4. spark参数配置-cloudera博客

离线安装pip包

pip安装

暂略

下载包而不安装

该命令会下载whl包,包括被依赖的包

pip install <包名> -d <目录> 或 pip install -d <目录> -r requirements.txt
pip install oauthlib -d .\oauthlib
新版pip: pip download -d DIR somepackage

安装全部包

pip install –no-index –find-links=DIR -r requirements.txt

内网使用

windows环境下,建立全局配置文件C:\ProgramData\pip\pip.ini

1
2
3
4
[global]
timeout = 3
index-url = https://pypi.tuna.tsinghua.edu.cn/simple
proxy = http://username:password@proxy.example.com:port

不知为啥,就算配置上trust-host、证书,在我司内网环境下用pypi的源依旧会报证书验证错误SSL3_GET_SERVER_CERTIFICATE

原理

yum install有参数--downloadonly,可以只下载不安装,搭配--downloaddir=DLDIR参数可以下载依赖包,完成离线安装。
命令实例:

1
2
3
4
5
# online machine: pwd --> /root
mkdir -p /root/download
yum install --downloadonly --downloaddir=/root/download <package-name>
tar zcf download.tar.gz download/

1
2
3
# offline machine: pwd --> /root
tar xf download.tar.gz
yum localinstall download/*

docker实例

按照官网说明,使用以上命令,获得的rpm包,基于Centos7.0-1406系统
https://github.com/Tony36051/docker-installer/tree/master/RPM-based/docker-ce-17.12-CentOS-7.0-1406
root权限执行一下命令即可:

sudo sh install.sh

可能的坑

rpm包有重复、冲突,体现为在安装xxx包时候,依赖项Requires,但是有重复或冲突,需要卸载Removing,并被yyy包更新Updated。但是这个过程不能自动化,因为yum不知道你冲突后要保留哪个。例子如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
--> Processing Dependency: rpm = 4.11.3-25.el7 for package: rpm-libs-4.11.3-25.el7.x86_64
--> Finished Dependency Resolution
Error: Package: 1:net-snmp-agent-libs-5.7.2-24.el7.i686 (@Server)
Requires: librpm.so.3
Removing: rpm-libs-4.11.3-17.el7.i686 (@Server)
librpm.so.3
Updated By: rpm-libs-4.11.3-25.el7.x86_64 (/rpm-libs-4.11.3-25.el7.x86_64)
Not found
Error: Package: rpm-build-libs-4.11.3-17.el7.x86_64 (@Server)
Requires: rpm-libs(x86-64) = 4.11.3-17.el7
Removing: rpm-libs-4.11.3-17.el7.x86_64 (@Server)
rpm-libs(x86-64) = 4.11.3-17.el7
Updated By: rpm-libs-4.11.3-25.el7.x86_64 (/rpm-libs-4.11.3-25.el7.x86_64)
rpm-libs(x86-64) = 4.11.3-25.el7
Error: Package: 1:net-snmp-agent-libs-5.7.2-24.el7.i686 (@Server)
Requires: librpmio.so.3
Removing: rpm-libs-4.11.3-17.el7.i686 (@Server)
librpmio.so.3
Updated By: rpm-libs-4.11.3-25.el7.x86_64 (/rpm-libs-4.11.3-25.el7.x86_64)
Not found
Error: Package: rpm-libs-4.11.3-25.el7.x86_64 (/rpm-libs-4.11.3-25.el7.x86_64)
Requires: rpm = 4.11.3-25.el7
Installed: rpm-4.11.3-17.el7.x86_64 (@Server)
rpm = 4.11.3-17.el7
You could try using --skip-broken to work around the problem
You could try running: rpm -Va --nofiles --nodigest

解决方法

  • 查看重复包
    1
    2
    3
    rpm -vqa | grep net-snmp-agent-
    net-snmp-agent-libs-5.7.2-24.el7.x86_64
    net-snmp-agent-libs-5.7.2-24.el7.i686
  • 卸载冲突包
    下面是卸载不符合系统的包,也有可能完把老版本全删掉,直接装新的
    1
    yum remove rpm-libs-4.11.3-17.el7.i686

Zabbix实践

安装

zabbix安装需要3大块,server负责整理数据,agent采集数据,web负责展示与GUI配置。
server和web都依赖关系型数据库,这里以mysql为例,也是docker形式。

1
2
3
4
5
docker run --name mysql --restart=always \
-v /home/tony/mysql_data:/var/lib/mysql \
-p 3306:3306 \
-e MYSQL_ROOT_PASSWORD=huawei123 \
-d mysql:5.6

Server端

1
2
3
4
5
6
7
8
docker run --name zabbix-server-mysql --restart always \
--link mysql:mysql_host \
-p 10051:10051 \
-e DB_SERVER_HOST="mysql_host" \
-e MYSQL_USER="root" \
-e MYSQL_PASSWORD="huawei123" \
-v /home/tony/zabbix/externalscripts:/usr/lib/zabbix/externalscripts \
-d zabbix/zabbix-server-mysql

Web端

1
2
3
4
5
6
7
8
9
10
11
12
docker run --name zabbix-web-nginx-mysql \
--restart always \
--link mysql:mysql_host \
--link zabbix-server-mysql:zabbix-server-mysql \
-p 81:80 \
-e DB_SERVER_HOST="mysql_host" \
-e MYSQL_USER="root" \
-e MYSQL_PASSWORD="huawei123" \
-e ZBX_SERVER_HOST="zabbix-server-mysql" \
-e PHP_TZ="Asia/Shanghai" \
-v /home/tony/zabbix/msyh.ttf:/usr/share/zabbix/fonts/graphfont.ttf \
-d zabbix/zabbix-web-nginx-mysql:latest

Agent

Agent用原生的rpm包安装,centos7.2下直接安装无依赖。生产环境要离线安装,找到以下仓库 http://repo.zabbix.com/zabbix/3.4/rhel/7/x86_64/
笔者在编辑时候,版本号为3.4,zabbix-get-3.4.7-1.el7.x86_64.rpm

sudo rpm -ivh zabbix-get-3.4.7-1.el7.x86_64.rpm

默认路径

/etc/zabbix #配置
/var/log/zabbix #日志
sudo systemctl restart zabbix-agent.service #systemd 重启

配置

判断进程是否存在、获取进程号

使用UserParameter功能,能在agent端执行自定义命令,命令的返回值会送到server作为键值对应的数值。

流程

  1. 在Agent端/etc/zabbix/zabbix_agentd.d/目录下新建参数自定义命令。
    1
    2
    3
    sudo vim /etc/zabbix/zabbix_agentd.d/userparameter_script.conf
    UserParameter=ps[*],ps -ef | grep $1 | grep -v zabbix | wc -l
    UserParameter=pid[*],ps -ef | grep "$1" | grep -v grep | sed -r 's/ +/ /g' | cut -d " " -f 2
  2. 在web端配置监控项,可以是active或passive,键值ps[NameNode],对应地会在agent端执行命令ps -ef | grep NameNode | grep -v zabbix | wc -l
  3. server端收到对应的返回值,正常来说是1。

Hadoop参数

流程

  1. server端执行外部检查,外部检查调用zabbix/externalscripts目录下执行系统命令(如调用 python get_dfs_info.py master1 50070)。
  2. 调用系统命令后,被调用程序应使用zabbix-sender给server端发送相关数据。
    这里发送的是文本文件,每行一条记录,空格划分三列,第一列是被监控机器在web上显示的hostname,第二列是键值,第三列是具体的数据。
  3. zabbix-server监控项用zabbix采集器,键值对应发送文件的第二列,数据类型要区分整数和字符串等。

脚本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
#!/bin/sh

#--------------------------------------------------------------------------------------------
# Expecting the following arguments in order -
# <host> = hostname/ip-address of Hadoop cluster NameNode server.
# This is made available as a macro in host configuration.
# <port> = Port # on which the NameNode metrics are available (default = 50070)
# This is made available as a macro in host configuration.
# <name_in_zabbix> = Name by which the Hadoop NameNode is configured in Zabbix.
# This is made available as a macro in host configuration.
# <monitor_type> is the parameter (NN or DFS) you want to monitor.
#--------------------------------------------------------------------------------------------

COMMAND_LINE="$0 $*"
export SCRIPT_NAME="$0"

usage() {
echo "Usage: $SCRIPT_NAME <host> <port> <name_in_zabbix> <monitor_type>"
}

if [ $# -ne 4 ]
then
usage ;
exit ;
fi


#--------------------------------------------------------------------------------------------
# First 2 parameters are required for connecting to Hadoop NameNode
# The 3th parameter HADOOP_NAME_IN_ZABBIX is required to be sent back to Zabbix to identify the
# Zabbix host/entity for which these metrics are destined.
# The 4th parameter MONITOR_TYPE is to specify the type to monitoring(NN or DFS)
#--------------------------------------------------------------------------------------------
export CLUSTER_HOST=$1
export METRICS_PORT=$2
export HADOOP_NAME_IN_ZABBIX=$3
export MONITOR_TYPE=$4

#--------------------------------------------------------------------------------------------
# Set the data output file and the log fle from zabbix_sender
#--------------------------------------------------------------------------------------------
export DATA_FILE="/tmp/${HADOOP_NAME_IN_ZABBIX}_${MONITOR_TYPE}.txt"
export JSON_FILE="/tmp/${HADOOP_NAME_IN_ZABBIX}_${MONITOR_TYPE}.json"
export BAK_DATA_FILE="/tmp/${HADOOP_NAME_IN_ZABBIX}_${MONITOR_TYPE}_bak.txt"
export LOG_FILE="/tmp/${HADOOP_NAME_IN_ZABBIX}.log"


#--------------------------------------------------------------------------------------------
# Use python to get the metrics data from Hadoop NameNode and use screen-scraping to extract
# metrics.
# The final result of screen scraping is a file containing data in the following format -
# <HADOOP_NAME_IN_ZABBIX> <METRIC_NAME> <METRIC_VALUE>
#--------------------------------------------------------------------------------------------

# python `dirname $0`/zabbix-hadoop.py $CLUSTER_HOST $METRICS_PORT $DATA_FILE $HADOOP_NAME_IN_ZABBIX $MONITOR_TYPE
wget -q -O $DATA_FILE http://$CLUSTER_HOST:$METRICS_PORT/jmx?qry=Hadoop:*

sh `dirname $0`/JSON.sh -l < $DATA_FILE > $JSON_FILE
#NN > JvmMetrics
heap_memory_used="`grep 'MemHeapUsedM' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
heap_memory="`grep 'MemHeapCommittedM' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
max_heap_memory="`grep 'MemHeapMaxM' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
non_heap_memory_used="`grep 'MemNonHeapUsedM' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
commited_non_heap_memory="`grep 'MemNonHeapCommittedM' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
all_memory_used=`awk 'BEGIN{print $heap_memory_used + $non_heap_memory_used}'`
#NN > NameNodeStatus
namenode_state="`grep 'tag.HAState' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
#NN > NameNodeInfo
start_time="`grep 'BlockDeletionStartTime' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
hadoop_version=`grep 'SoftwareVersion' $JSON_FILE | sed -n '1,1p' | cut -f 2 | cut -d \" -f 2`
# DFS > FSNamesystemState
live_nodes="`grep 'NumLiveDataNodes' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
dead_nodes="`grep 'NumDeadDataNodes' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
decommissioning_nodes="`grep 'NumDecommissioningDataNodes' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
under_replicated_blocks="`grep 'UnderReplicatedBlocks' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
# DFS > NameNodeInfo
files_and_directorys="`grep 'TotalFiles' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
blocks="`grep 'TotalBlocks' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
configured_capacity="`grep '\"Total\"' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
dfs_used="`grep 'CapacityUsed' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
dfs_used_persent="`grep 'PercentUsed' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
non_dfs_used="`grep 'NonDfsUsedSpace' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
dfs_remaining="`grep 'Free' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
dfs_remaining_persent="`grep 'PercentRemaining' $JSON_FILE | sed -n '1,1p' | cut -f 2`"
datanodes_usages="`grep 'NodeUsage' $JSON_FILE | sed -n '1,1p' | cut -f 2`"

echo "$HADOOP_NAME_IN_ZABBIX heap_memory_used $heap_memory_used
$HADOOP_NAME_IN_ZABBIX heap_memory $heap_memory
$HADOOP_NAME_IN_ZABBIX max_heap_memory $max_heap_memory
$HADOOP_NAME_IN_ZABBIX non_heap_memory_used $non_heap_memory_used
$HADOOP_NAME_IN_ZABBIX commited_non_heap_memory $commited_non_heap_memory
$HADOOP_NAME_IN_ZABBIX all_memory_used $all_memory_used
$HADOOP_NAME_IN_ZABBIX namenode_state $namenode_state
$HADOOP_NAME_IN_ZABBIX start_time $start_time
$HADOOP_NAME_IN_ZABBIX hadoop_version $hadoop_version
$HADOOP_NAME_IN_ZABBIX live_nodes $live_nodes
$HADOOP_NAME_IN_ZABBIX dead_nodes $dead_nodes
$HADOOP_NAME_IN_ZABBIX decommissioning_nodes $decommissioning_nodes
$HADOOP_NAME_IN_ZABBIX under_replicated_blocks $under_replicated_blocks
$HADOOP_NAME_IN_ZABBIX files_and_directorys $files_and_directorys
$HADOOP_NAME_IN_ZABBIX blocks $blocks
$HADOOP_NAME_IN_ZABBIX configured_capacity $configured_capacity
$HADOOP_NAME_IN_ZABBIX dfs_used $dfs_used
$HADOOP_NAME_IN_ZABBIX dfs_used_persent $dfs_used_persent
$HADOOP_NAME_IN_ZABBIX non_dfs_used $non_dfs_used
$HADOOP_NAME_IN_ZABBIX dfs_remaining $dfs_remaining
$HADOOP_NAME_IN_ZABBIX dfs_remaining_persent $dfs_remaining_persent
$HADOOP_NAME_IN_ZABBIX datanodes_usages $datanodes_usages" > $DATA_FILE


#--------------------------------------------------------------------------------------------
# Check the size of $DATA_FILE. If it is not empty, use zabbix_sender to send data to Zabbix.
#--------------------------------------------------------------------------------------------
if [[ -s $DATA_FILE ]]
then
zabbix_sender -vv -z 127.0.0.1 -i $DATA_FILE 2>>$LOG_FILE 1>>$LOG_FILE
echo -e "Successfully executed $COMMAND_LINE" >>$LOG_FILE
mv $DATA_FILE $BAK_DATA_FILE
echo "OK"
else
echo "Error in executing $COMMAND_LINE" >> $LOG_FILE
echo "ERROR"
fi


# debug: sh cluster-hadoop-plugin.sh 10.41.236.209 50070 master1 DFS

监控项 示例

外部检查:

1
cluster-hadoop-plugin.sh ${HADOOP_NAMENODE_HOST} ${HADOOP_NAMENODE_METRICS_PORT} ${ZABBIX_NAME} DFS

监控项
Zabbix采集器:键值live_nodes

如何调试

agent机器进入zabbix用户调试

如果需要在被监控机器执行脚本获取监控数据,可以使用UserParameter功能,Agent将会在被监控机器上以zabbix用户执行对应的命令。经常会出现权限问题等,调试时需要切换用户,以下是切换用户的命令:

sudo su -s /bin/bash zabbix